Wenn Sie eine Datenbanktabelle entwerfen — wie entscheiden Sie, welcher numerische Typ für eine Spalte der richtige ist?
„Nimm einfach INT für Ganzzahlen.“ „Sicherheitshalber lieber BIGINT.“ „Hat Nachkommastellen, also FLOAT.“ Klingt vertraut? Damit sind Sie nicht allein. Doch dieses Bauchgefühl-Design führt zu Performance-Problemen, verschwendetem Speicher und sogar kritischen Fehlern bei Finanzberechnungen.
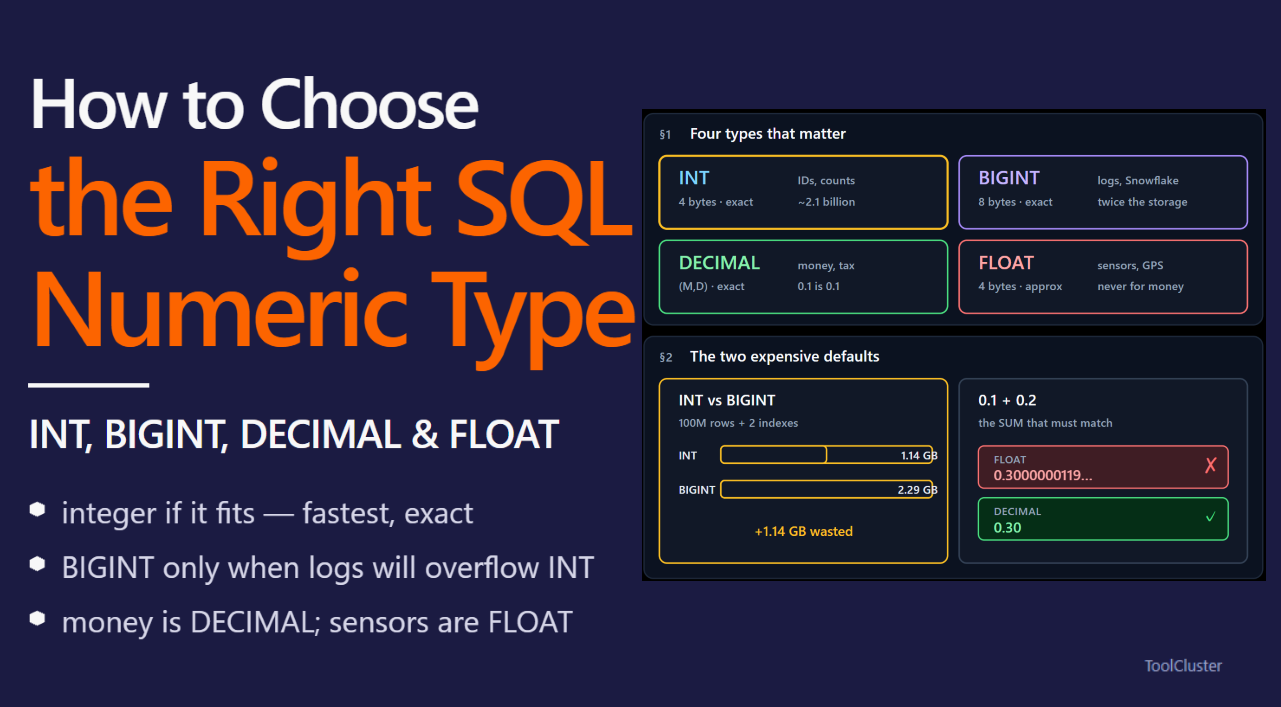
Ein Beispiel: Der Wechsel von INT zu BIGINT für eine einzige Spalte in einer 100-Millionen-Zeilen-Tabelle verbraucht rund 400 MB zusätzlichen Speicher. Mit zwei Indizes übersteigt die Differenz 1 GB. Am anderen Ende des Spektrums kann die Wahl von INT für eine Log-Tabelle mit Millionen neuer Zeilen pro Tag nach wenigen Jahren zum Overflow-Crash führen — Ihre gesamte Anwendung steht still.
Und dann ist da FLOAT. Die meisten Entwickler wissen, dass 0.1 + 0.2 nicht 0.3 ergibt, sondern 0.30000000000000004. Trotzdem landen FLOAT-Spalten in Produktions-Zahlungstabellen, wo sie leise Rundungsfehler ansammeln, bis die monatlichen Umsatzberichte nicht mehr aufgehen.
Dieser Artikel ist ein umfassender Leitfaden zu den vier wichtigsten numerischen SQL-Datentypen — INT, BIGINT, DECIMAL und FLOAT — mit ihren Unterschieden, Trade-offs und praktischen Entscheidungsregeln, die Sie sofort anwenden können.
Bei der FLOAT-Rundung vertieft eine Grafik das Verständnis mehr als ein Text. In Warum stimmt die FLOAT-Summe nicht? können Sie dasselbe 0,1 + 0,2 auch in interaktiven Grafiken sehen.
SQL-Datentypen im Überblick
SQL kennt viele Datentypen — Zeichenketten, Datumswerte, Booleans, JSON. Diese Seite ist der numerische Ausschnitt: welcher Typ eine Zahl speichert, wie groß sie werden darf, und ob der Wert exakt ist. Zeichen- und Datumstypen liegen außerhalb.
Die Tabelle unten ist dieser Ausschnitt auf einen Blick. DECIMAL ist der exakte Dezimaltyp, deklariert als DECIMAL(M, D) (Stellen insgesamt, dann Nachkommastellen). Die folgenden Abschnitte gehen in die Tiefe.
| Typ | Größe | Wertebereich (ca.) | Genauigkeit | Typischer Einsatz |
|---|---|---|---|---|
| TINYINT | 1 Byte | 0 – 255 / -128 – 127 | Exakt | Flags, Statuscodes |
| SMALLINT | 2 Bytes | 0 – 65.535 | Exakt | Kleine Zähler |
| INT | 4 Bytes | ~2,1 Mrd. / ~4,2 Mrd. | Exakt | IDs, Mengen, Zähler |
| BIGINT | 8 Bytes | ~9,2 Trillionen | Exakt | Log-IDs, große PKs |
| DECIMAL(M,D) | Variabel | M Stellen (D Nachkommastellen) | Exakt | Geldbeträge, Steuersätze |
| FLOAT | 4 Bytes | ±3,4 × 10³⁸ | Näherung | Temperatur, Sensordaten |
| DOUBLE | 8 Bytes | ±1,7 × 10³⁰⁸ | Näherung | GPS-Koordinaten, Statistik |
Die vier Typen, die im Alltag am wichtigsten sind: INT, BIGINT, DECIMAL und FLOAT. Beherrschen Sie diese vier, meistern Sie die überwältigende Mehrheit realer Datenbankdesigns ohne Probleme.
Ganzzahltypen (INT-Familie) — Der Standard-Ausgangspunkt
Ganzzahlen sind der schnellste, speichereffizienteste und fehlerfreie numerische Typ in SQL. Sie gewinnen bei Rechengeschwindigkeit, Index-Effizienz und Speicherbedarf. Wenn eine Spalte keine Nachkommastellen benötigt, ist ein Ganzzahltyp immer die richtige Wahl.
MySQL bietet fünf Ganzzahlgrößen:
| Typ | Größe | SIGNED-Bereich | UNSIGNED-Bereich |
|---|---|---|---|
| TINYINT | 1 Byte | -128 bis 127 | 0 bis 255 |
| SMALLINT | 2 Bytes | -32.768 bis 32.767 | 0 bis 65.535 |
| MEDIUMINT | 3 Bytes | -8.388.608 bis 8.388.607 | 0 bis 16.777.215 |
| INT | 4 Bytes | -2.147.483.648 bis 2.147.483.647 | 0 bis 4.294.967.295 |
| BIGINT | 8 Bytes | -9,2 Trillionen bis 9,2 Trillionen | 0 bis ~18,4 Trillionen |
Die Tabelle gilt für MySQL (und MariaDB). SQL Server und PostgreSQL haben eine kleinere Ganzzahlfamilie: kein MEDIUMINT, und INT ist immer vorzeichenbehaftet. In beiden ist INT 4 Byte groß, Maximum 2.147.483.647 (Minimum −2.147.483.648). UNSIGNED gibt es nicht, also reicht der positive Bereich von 4,2 Milliarden auf INT nicht — darüber BIGINT.
Die goldene Regel: Wenn sich ein Wert als Ganzzahl darstellen lässt, verwenden Sie einen Ganzzahltyp. Beispiel: Wenn Ihr System Preise in ganzen Cent speichert, funktioniert preis_cent INT einwandfrei. INT reicht bis etwa 2,1 Milliarden — das entspricht Beträgen bis 21 Millionen Euro in Cent, mehr als genug für die meisten E-Commerce-Produkte.
Typische Ganzzahl-Anwendungsfälle:
- IDs (Primärschlüssel): user_id, product_id, order_id
- Mengen: lagerbestand, warenkorb_anzahl
- Zähler: login_anzahl, aufruf_anzahl, wiederholungsversuche
- Statuscodes: bestellstatus (0 = ausstehend, 1 = bezahlt, 2 = versendet …)
- Boolesche Flags: ist_aktiv, ist_geloescht (TINYINT mit 0/1)
Es gibt keinen Grund, DECIMAL oder FLOAT für diese Spalten zu verwenden. Ganzzahlen sind die schnellste und sicherste Wahl.
INT vs. BIGINT — Ist „sicherheitshalber größer“ wirklich sicher?
Der Unterschied ist die Größe. INT hat 4 Byte, BIGINT 8. Ein vorzeichenbehaftetes INT läuft von −2.147.483.648 bis 2.147.483.647. Der BIGINT-Bereich liegt bei etwa ±9,2×10¹⁸ — Überlauf ist ein Planungsproblem, kein Release-Problem. Die extra 4 Byte liegen auch in jedem Index, der die Spalte enthält.
Das übliche Dilemma ist nicht „was ist der Unterschied?“, sondern „nehme ich BIGINT, um sicher zu gehen?“. INT reicht für die meisten IDs und Zähler. INT UNSIGNED (MySQL) endet bei etwa 4,2 Milliarden. Deutschland hat rund 84 Millionen Einwohner, 2 % davon. Ein Dienst mit einer Million Nutzern kann 4.000 Logzeilen je Nutzer in INT halten. Jede Ganzzahl auf BIGINT zu heben ist keine kostenlose Versicherung, sondern ein teures Anti-Pattern.
Wann wird BIGINT also wirklich nötig?
- Zugriffsprotokolle: Eine Website mit 100 Millionen Seitenaufrufen pro Monat sammelt 1,2 Milliarden Zeilen pro Jahr. Innerhalb von 3–4 Jahren kommt die INT-Obergrenze in Sichtweite
- IoT-Sensordaten: 10.000 Geräte, die jede Sekunde Daten senden, erzeugen rund 315 Milliarden Zeilen pro Jahr — weit jenseits des INT-Bereichs
- Verteilte IDs (Snowflake u. a.): Diese kodieren Zeitstempel, Worker-ID und Sequenznummer in einem einzigen Wert, der extrem groß sein kann
- Transaktions-IDs: Ein Zahlungssystem mit 1 Million Transaktionen pro Tag erreicht in 10 Jahren 3,65 Milliarden — gefährlich nah an der INT-Obergrenze
Jetzt beziffern wir die Kosten von „einfach überall BIGINT“:
| Szenario | INT (4 Bytes) | BIGINT (8 Bytes) | Differenz |
|---|---|---|---|
| 100 Mio. Zeilen × 1 Spalte | 381 MB | 762 MB | +381 MB |
| 100 Mio. Zeilen × 1 Spalte + 2 Indizes | 1,14 GB | 2,29 GB | +1,14 GB |
| JOIN-Speicher (geschätzt) | Baseline | ~1,5–2× | Geringere Cache-Effizienz |
Bei einer 100-Millionen-Zeilen-Tabelle verschwendet das Hochstufen einer einzelnen Spalte plus zwei Indizes von INT auf BIGINT über 1,1 GB. Multiplizieren Sie das über mehrere Spalten und Tabellen, und die Summe erreicht zweistellige Gigabyte — mehr Disk-I/O, geringere Buffer-Pool-Effizienz und langsamere Abfragen.
Ein praktischer Entscheidungsleitfaden:
| Spalten-Zweck | Empfohlener Typ | Begründung |
|---|---|---|
| Benutzer-ID | INT UNSIGNED | Kaum ein Dienst überschreitet 4,2 Mrd. Nutzer |
| Produkt-ID | INT UNSIGNED | Gleiche Begründung |
| Bestell-ID | INT UNSIGNED oder BIGINT | Abhängig von Volumen und Lebensdauer |
| Zugriffslog-ID | BIGINT | Milliarden Zeilen pro Jahr erwartet |
| Snowflake / Numerische UUID | BIGINT | Werte sind von Natur aus groß |
Orientieren Sie sich nicht nur an der aktuellen Zeilenzahl. Entscheidend ist die Wachstumsrate über die gesamte Betriebszeit. Schätzen Sie die jährlichen Einfügungen, rechnen Sie 10 Jahre voraus, und prüfen Sie, ob INT UNSIGNED (4,2 Milliarden) ausreicht. Falls nicht, starten Sie von Tag eins mit BIGINT.
UNSIGNED — Doppelter Wertebereich zum Nulltarif
In MySQL und MariaDB entfernt das Schlüsselwort UNSIGNED bei einer Ganzzahlspalte den negativen Bereich und verdoppelt den positiven Bereich — ohne zusätzlichen Speicherbedarf. Ein regulärer INT reicht von etwa -2,1 Milliarden bis +2,1 Milliarden; INT UNSIGNED reicht von 0 bis 4,2 Milliarden — bei denselben 4 Bytes.
Spalten wie IDs, Mengen und Zähler sind niemals negativ. Es gibt keinen Grund, hier nicht UNSIGNED zu verwenden.
CREATE TABLE users (
  id          INT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  age         TINYINT UNSIGNED,          -- 0<=255 reicht völlig
  login_count INT UNSIGNED DEFAULT 0,
  punkte      INT UNSIGNED DEFAULT 0
);Subtraktion zwischen zwei UNSIGNED-Spalten kann zu einem Unterlauf führen. In MySQL liefert SELECT a - b bei a < b einen riesigen Wert (oder einen Fehler), weil das Ergebnis umschlägt. Wenn Subtraktion möglich ist, verwenden Sie CAST(a AS SIGNED) - CAST(b AS SIGNED) oder behalten Sie die Spalte als SIGNED.
PostgreSQL unterstützt kein UNSIGNED. Die gängige Lösung ist ein CHECK-Constraint (CHECK (id >= 0)), um nichtnegative Werte auf Anwendungsebene sicherzustellen.
DECIMAL (NUMERIC) — Die einzig richtige Wahl für Geldbeträge
In SQL ist DECIMAL (auch NUMERIC) ein exakter Dezimaltyp. Deklaration: DECIMAL(M, D) — M ist die Stellenzahl insgesamt, D die Nachkommastellen. Die Engine speichert Dezimalziffern, daher bleibt 0,1 gleich 0,1, keine Binärnäherung. FLOAT macht das Gegenteil; deshalb scheitert dort 0.1 + 0.2.
Darum ist DECIMAL der Typ für Geld. Überall, wo selbst ein Bruchteil eines Cents zählt — Preise, Rechnungen, Steuern, Kontostände — ist es die einzig akzeptable Wahl.
Warum nicht FLOAT? Sehen wir uns das Problem in Aktion an:
-- Was passiert mit FLOAT
SELECT CAST(0.1 AS FLOAT) + CAST(0.2 AS FLOAT);
-- Ergebnis: 0.30000001192092896 (nicht 0.3)

-- DECIMAL liefert das korrekte Ergebnis
SELECT CAST(0.1 AS DECIMAL(10,2)) + CAST(0.2 AS DECIMAL(10,2));
-- Ergebnis: 0.30 (exakt 0.30)
Wie wirkt sich dieser winzige Fehler in der Praxis aus? Stellen Sie sich einen Online-Shop vor, der einen Artikel für 11,99 € verkauft und 50.000 Bestellungen pro Monat verarbeitet:
- Mit FLOAT: Jede Zeile kann einen Fehler von +0,000001 aufweisen, aber über 50.000 Zeilen und mehrere Steuerberechnungen summieren sich die Rundungsabweichungen. Multipliziert über hunderte Artikel im Laufe eines Jahres driftet das Hauptbuch um Euro-Beträge ab — genug, um eine Buchprüfung auszulösen
- Mit DECIMAL: Keine Abweichung. Jede Aggregation stimmt auf den Cent genau, jedes Mal
„Es ist doch nur ein Millionstel Euro.“ Stimmt — aber in der Buchhaltung gilt: Wenn die Bücher nicht centgenau aufgehen, muss jemand erklären warum. „Wir haben den falschen Spaltentyp verwendet“ ist keine Antwort, die ein Wirtschaftsprüfer akzeptiert.
DECIMAL wird als DECIMAL(M, D) deklariert, wobei M die Gesamtstellenzahl und D die Nachkommastellen angibt:
-- DECIMAL(10,2): 10 Stellen gesamt, 2 Nachkommastellen
-- Maximalwert: 99.999.999,99

CREATE TABLE bestellungen (
  id         INT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  nettobetrag DECIMAL(10,2) NOT NULL,  -- Betrag vor Steuer
  mwst_satz   DECIMAL(5,4)  NOT NULL,  -- z. B. 0.1900 (19% MwSt)
  mwst_betrag DECIMAL(10,2) NOT NULL,  -- Mehrwertsteuer
  gesamt      DECIMAL(10,2) NOT NULL   -- Gesamtbetrag
);DECIMAL und NUMERIC sind im SQL-Standard Synonyme. MySQL, PostgreSQL und SQL Server behandeln sie identisch. Wählen Sie eines und bleiben Sie in Ihrer Codebasis konsistent.
DECIMAL richtig dimensionieren — Warum DECIMAL(18,10) fast immer übertrieben ist
Ein weiterer häufiger Fehler ist das Festlegen übermäßiger Genauigkeit: DECIMAL(18,10) oder sogar DECIMAL(30,15) „für den Fall der Fälle“. Das verschwendet Speicher und verlangsamt Aggregationen.
Der Speicherbedarf von DECIMAL ist proportional zur Stellenzahl. In MySQL verbrauchen jeweils 9 Stellen 4 Bytes, mit zusätzlichen Bytes für den Rest:
| Typ | Speicher (MySQL) | Anwendungsbeispiel |
|---|---|---|
| DECIMAL(5,2) | 3 Bytes | Prozentsätze (bis 99,99 %) |
| DECIMAL(10,2) | 5 Bytes | Preise (bis 99.999.999,99 €) |
| DECIMAL(12,4) | 6 Bytes | Wechselkurse (z. B. 1,3456) |
| DECIMAL(18,10) | 9 Bytes | Für die meisten Anwendungen übertrieben |
Der richtige Ansatz ist, vom Maximalwert rückwärts zu arbeiten:
- E-Commerce-Preise: Wenn der höchste Preis bei einigen Millionen Euro liegt, deckt DECIMAL(10,2) bis zu 99.999.999,99 € ab
- Mehrwertsteuersätze: In Deutschland beträgt der reguläre Satz 19 %, der ermäßigte 7 %. DECIMAL(5,4) reicht bis 99,9999 %
- Rabatt-Prozentsätze: 0–100 % passt in DECIMAL(5,2)
- Wechselkurse: EUR/USD bei 1,0845 — DECIMAL(12,4) bietet reichlich Spielraum
- Kryptowährungen: Die kleinste Einheit von Ethereum (Wei = 10⁻¹⁸ ETH) erfordert tatsächlich DECIMAL(36,18) — einer der seltenen Fälle, in denen extreme Genauigkeit gerechtfertigt ist
DECIMAL(18,10) für eine Einzelhandelspreisspalte zu verwenden, ist wie eine persönliche Notiz auf A0-Papier zu drucken. Dimensionieren Sie die Genauigkeit passend — das spart Speicher und beschleunigt Abfragen.
FLOAT / DOUBLE — Geschwindigkeit auf Kosten der Exaktheit
FLOAT und DOUBLE sind Gleitkommatypen, die Dezimalzahlen im IEEE-754-Binärformat darstellen. Das bringt einen großen Vorteil und eine inhärente Einschränkung.
Der Vorteil ist offensichtlich: Feste 4 Bytes (FLOAT) oder 8 Bytes (DOUBLE) können einen enormen Wertebereich darstellen. FLOAT allein deckt ±3,4 × 10³⁸ ab, und die Gleitkomma-Hardware der CPU macht die Arithmetik extrem schnell.
Die Einschränkung ist, dass Näherungswerte gespeichert werden, keine exakten Werte. Die Dezimalzahl 0,1 wird zur unendlich periodischen Binärzahl 0,000110011001100…, die auf eine endliche Bitanzahl gerundet werden muss. Dies ist die Ursache des berühmten „0,1 + 0,2 ≠ 0,3″-Problems.
Warum das passiert — und wie Fehler, die in einer einzelnen Zeile unsichtbar sind, sich in einer SUM auftürmen, bis die Bücher nicht mehr stimmen — zeigt Warum stimmt die FLOAT-Summe nicht? mit interaktiven Grafiken zum Ausprobieren.
FLOAT ist die richtige Wahl, wenn kleine Rundungsfehler das Ergebnis nicht beeinflussen:
- Temperaturmessungen: Ein Werkssensor meldet 23,45 °C mit einer Eigengenauigkeit von ±0,1 °C. Ein Speicherfehler von ±0,0001 °C ist bedeutungslos
- GPS-Koordinaten: Sechs Dezimalstellen bei Längen-/Breitengrad entsprechen ~11 cm Genauigkeit. DOUBLE bewahrt bis zu 15 signifikante Stellen — Sub-Millimeter-Genauigkeit, die jeden realen Bedarf weit übertrifft
- Machine-Learning-Features: ML-Modelle haben Millionen bis Milliarden Parameter; mikroskalige Rundung bei einem einzelnen Gewicht hat vernachlässigbaren Einfluss auf die Gesamtgenauigkeit
- Physiksimulationen: Strömungsdynamik und Strukturanalysen setzen auf FLOATs Geschwindigkeit, wobei der Fehler auf Algorithmusebene kontrolliert wird
- Statistische Aggregate: Mittelwerte, Standardabweichungen und Korrelationen werden aus Daten berechnet, die bereits statistisches Rauschen enthalten
Die Wahl zwischen FLOAT und DOUBLE hängt von Genauigkeit und Speicher ab:
| Typ | Größe | Signifikante Stellen | Wann wählen |
|---|---|---|---|
| FLOAT | 4 Bytes | ~7 | Speichersensitiv, Sensordaten |
| DOUBLE | 8 Bytes | ~15 | Hohe Genauigkeit: GPS, wissenschaftliches Rechnen |
GPS-Koordinaten als FLOAT zu speichern liefert nur ~7 signifikante Stellen — etwa 11 m Genauigkeit. Für eine Kartenanwendung ist DOUBLE (~15 Stellen, Sub-Millimeter) die klare Wahl. Umgekehrt ist es sinnlos, Temperatursensordaten als DOUBLE zu speichern, wenn der Sensor selbst nur auf ±0,5 °C genau ist — FLOAT genügt vollkommen.
FLOAT vs. DECIMAL — Schnelle Entscheidungshilfe
In der Praxis müssen Sie diese Entscheidung schnell und sicher treffen. Hier ist eine Referenztabelle:
| Anwendungsfall | DECIMAL | FLOAT / DOUBLE |
|---|---|---|
| Preise, Rechnungen, Abrechnung | ✓ | ✗ (niemals) |
| Steuersätze, Rabatte | ✓ | ✗ |
| Treuepunkte / Meilen | ✓ (bei Bruchteilen) | ✗ |
| Bestandsgewicht (kg, lb) | ✓ | △ |
| Temperatur / Luftfeuchtigkeit | △ | ✓ |
| GPS-Koordinaten | △ | ✓ (DOUBLE) |
| Sensordaten | △ | ✓ |
| ML-Features / Scores | ✗ | ✓ |
| Statistische Werte (Mittelwert usw.) | △ | ✓ |
Die Faustregel passt in drei Zeilen:
- Geld im Spiel → DECIMAL
- Messung oder Wissenschaft → FLOAT / DOUBLE
- Unsicher → DECIMAL (lieber auf der sicheren Seite)
Merken Sie sich diese drei Regeln und Sie werden selten falsch liegen.
Neugierig, warum eine FLOAT-SUM überhaupt abdriftet? Siehe Warum stimmt die FLOAT-Summe nicht?
Fünf häufige Design-Fehler
Fehler bei numerischen Typen bleiben während der Entwicklung oft unsichtbar und zeigen sich erst in der Produktion. Hier sind die fünf häufigsten.
Fehler 1: Jede Spalte zu BIGINT machen
Die „Größer ist sicherer“-Mentalität verleitet Teams dazu, jede Ganzzahlspalte auf BIGINT zu setzen. Wie oben gezeigt, kann das pro 100 Millionen Zeilen über 1 GB für eine einzige Spalte plus Indizes verschwenden. Über 10 Tabellen mit je 3 BIGINT-Spalten sind das rund 12 GB verschwendeter Speicher — mit direkten Auswirkungen auf Cloud-Hosting-Kosten und Buffer-Pool-Effizienz.
Fehler 2: FLOAT für Geldbeträge verwenden
Dies ist der gefährlichste Fehler auf der Liste. Er besteht oft alle Unit-Tests, weil Rundungsfehler bei kleinem Datenvolumen unsichtbar sind. Das Problem zeigt sich in der Produktion, wenn das Transaktionsvolumen wächst: „Der monatliche Umsatz stimmt nicht mit den tatsächlichen Bankgutschriften überein.“ Die Ursachenanalyse dauert Tage, und die nachträgliche Korrektur von FLOAT-gespeicherten Finanzdaten ist äußerst schwierig.
Fehler 3: DECIMAL-Genauigkeit überdimensionieren
Die Definition DECIMAL(30,15) „für alle Fälle“ verschwendet Speicher und verlangsamt Aggregationsabfragen. Außerhalb von Kryptowährungen (wo 18 Nachkommastellen tatsächlich benötigt werden) erfordern nur sehr wenige Geschäftsbereiche mehr als 4 Nachkommastellen.
Fehler 4: INT-Overflow nicht vorhersehen
Eine Tabelle mag mit nur wenigen hundert Einfügungen pro Tag beginnen, aber das Wachstum kann exponentiell sein. INT SIGNED endet bei ~2,1 Milliarden. Bei 50.000 AUTO_INCREMENT-Einfügungen pro Tag ergibt das 117 Jahre Spielraum — doch Testdaten-Dumps, ID-Lücken und unerwartetes Wachstum können diese Reserve schneller aufbrauchen als erwartet. Überwachen Sie Ihre AUTO_INCREMENT-Höchstwerte regelmäßig.
Fehler 5: Unterschiedliche Typen in JOINs
Wenn bestellungen.user_id INT ist, aber users.id BIGINT, löst jeder JOIN eine implizite Typkonvertierung aus. In MySQL kann dies den Optimizer daran hindern, Indizes zu verwenden, und verwandelt eine Millisekunden-Abfrage in einen mehrsekündigen Full-Table-Scan. Stellen Sie immer sicher, dass Spalten in JOINs exakt denselben Typ verwenden.
Empfohlene Typen nach Anwendungsfall
Nutzen Sie diese Schnellreferenz beim Entwerfen neuer Tabellen:
| Spalten-Zweck | Empfohlener Typ | Hinweise |
|---|---|---|
| Benutzer-ID | INT UNSIGNED | 4,2 Mrd. reicht aus |
| Produkt-ID | INT UNSIGNED | Gleiche Begründung |
| Log- / Event-ID | BIGINT UNSIGNED | Milliarden Zeilen pro Jahr |
| Snowflake-ID | BIGINT | Von Natur aus große Werte |
| Produktpreis | DECIMAL(10,2) | Max 99.999.999,99 € |
| Steuersatz (MwSt) | DECIMAL(5,4) | z. B. 0.1900 (19 %) |
| Rabattsatz | DECIMAL(5,2) | z. B. 15,50 % |
| Wechselkurs | DECIMAL(12,4) | z. B. 1,0845 |
| Lagerbestand (Ganzzahl) | INT UNSIGNED | Keine Nachkommastellen nötig |
| Gewicht (kg / lb) | DECIMAL(8,3) | z. B. 12345,678 |
| Temperatur | FLOAT | Sensorgenauigkeit reicht aus |
| GPS-Breite / -Länge | DOUBLE | Hohe Genauigkeit erforderlich |
| ML-Feature | FLOAT | Geschwindigkeit vor Genauigkeit |
| Punkte (Ganzzahl) | INT UNSIGNED | Keine Bruchteile |
| Punkte (mit Nachkommastellen) | DECIMAL(10,2) | Flugmeilen usw. |
| Ranglistenposition | INT UNSIGNED | Rankings sind nie negativ |
| Boolesches Flag (0/1) | TINYINT UNSIGNED | MySQLs BOOLEAN unter der Haube |
| Statuscode | TINYINT oder SMALLINT | Größe an den Wertebereich anpassen |
Eine solche Tabelle im Team zu teilen, eliminiert die meisten Typauswahl-Debatten im Code-Review.
CREATE TABLE — Praxisbeispiele
Zum Abschluss drei produktionsreife Tabellendefinitionen. Achten Sie darauf, wie jede Spalte den kleinstmöglichen passenden Typ verwendet.
Beispiel 1: E-Commerce-Produkte
CREATE TABLE produkte (
  id          INT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  name        VARCHAR(255) NOT NULL,
  preis       DECIMAL(10,2) NOT NULL DEFAULT 0.00,  -- Geld = DECIMAL
  mwst_satz   DECIMAL(5,4) NOT NULL DEFAULT 0.1900, -- 19% MwSt = 0.1900
  lagerbestand INT UNSIGNED NOT NULL DEFAULT 0,      -- Ganzzahlige Menge
  gewicht_kg  DECIMAL(8,3),                          -- Versandgewicht
  bewertung   FLOAT,                                 -- Durchschnittliche Nutzerbewertung
  ist_aktiv   TINYINT UNSIGNED NOT NULL DEFAULT 1,   -- Boolesches Flag
  erstellt_am DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Beispiel 2: Zugriffsprotokolle
CREATE TABLE zugriffsprotokolle (
  id          BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, -- Hohes Volumen
  user_id     INT UNSIGNED,               -- Typ stimmt mit users.id überein
  status_code SMALLINT UNSIGNED NOT NULL,  -- HTTP 200, 404, 500...
  antwort_ms  INT UNSIGNED,                -- Antwortzeit in ms
  erstellt_am DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  INDEX idx_user (user_id),
  INDEX idx_erstellt (erstellt_am)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Beispiel 3: IoT-Sensormesswerte
CREATE TABLE sensormesswerte (
  id            BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  geraet_id     INT UNSIGNED NOT NULL,
  temperatur    FLOAT,          -- Sensorgenauigkeit reicht aus
  luftfeuchtigkeit FLOAT,       -- Ebenso
  breitengrad   DOUBLE,         -- GPS braucht hohe Genauigkeit
  laengengrad   DOUBLE,         -- Ebenso
  akku_prozent  TINYINT UNSIGNED, -- Akku 0-100%
  erfasst_am    DATETIME(3) NOT NULL, -- Millisekunden-Genauigkeit
  INDEX idx_geraet_zeit (geraet_id, erfasst_am)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Alle drei Tabellen teilen ein gemeinsames Merkmal: Jede Spalte ist mit dem kleinsten Typ definiert, der ihrem Zweck entspricht. IDs skalieren mit INT oder BIGINT je nach Bedarf, Geldbeträge verwenden DECIMAL, Messwerte verwenden FLOAT/DOUBLE, und Flags verwenden TINYINT. So sieht ein gut entworfenes Schema aus.
Zusammenfassung — Typwahl ist Performance-Engineering
Die Wahl eines numerischen SQL-Typs ist nicht nur eine Formatierungsentscheidung. Sie beeinflusst Speichereffizienz, Index-Performance, Abfragegeschwindigkeit, Datengenauigkeit und Zukunftsskalierbarkeit — alles gleichzeitig.
Das Wesentliche in vier Zeilen:
- Passt es in eine Ganzzahl, verwenden Sie einen Ganzzahltyp (schnellste, kleinste, null Fehler)
- INT für die meisten Spalten, BIGINT für Hochvolumen-Logs (Speicher verdoppelt sich)
- DECIMAL für Geldbeträge — ohne Ausnahme (FLOAT-Fehler sind im Finanzbereich verheerend)
- FLOAT / DOUBLE für Wissenschaft und Messungen (Geschwindigkeit und Wertebereich, wo Näherung ausreicht)
Das Leitprinzip lautet: Wählen Sie den kleinsten Typ, der Ihre Anforderungen erfüllt. Überdimensionierte Typen verschwenden Speicher, reduzieren die Cache-Effizienz und verlangsamen Abfragen. Zu kleine Typen riskieren einen Overflow. Die richtige Wahl erfordert eine Einschätzung der Datennatur (Ganzzahl vs. Dezimal), des Wertebereichs, der Fehlertoleranz und der Wachstumsrate über die Systemlebensdauer.
Die Wahl des numerischen Datentyps ist unspektakuläre Arbeit, aber die richtige Entscheidung von Tag eins erspart Ihnen Performance-Degradation, Speicheraufblähung und Produktionsvorfälle. Fragen Sie sich bei jedem CREATE TABLE: „Ist dieser Typ wirklich der passende?“ Allein diese Gewohnheit hebt die Qualität Ihres Datenbankdesigns deutlich an.
FAQ
F. Woran sollte ich zuerst denken, wenn ich unsicher bin, welchen Typ ich verwenden soll?
A. Fragen Sie sich zunächst: „Lässt sich dieser Wert als Ganzzahl darstellen?“ Falls ja, nehmen Sie einen INT-Typ. Dann: „Hat es mit Geld zu tun?“ Falls ja, ist DECIMAL die einzige Antwort. Alles andere mit Nachkommastellen — Temperaturen, Koordinaten, Scores — deutet auf FLOAT oder DOUBLE. Folgen Sie dieser Reihenfolge, und 95 % der Entscheidungen sind sofort klar.
F. Wie aufwendig ist eine spätere Migration von INT zu BIGINT?
A. MySQLs ALTER TABLE ... MODIFY COLUMN kann den Typ ändern, aber bei großen Tabellen sperrt es die Tabelle für Minuten oder sogar Stunden. Tools wie pt-online-schema-change oder gh-ost führen die Migration mit nahezu null Downtime durch, erfordern aber sorgfältige Planung. Den Typ von Anfang an richtig zu wählen, ist immer günstiger als eine nachträgliche Korrektur.
F. PostgreSQL unterstützt kein UNSIGNED — was soll ich tun?
A. Richtig. Der Standard-PostgreSQL-Ansatz ist ein CHECK-Constraint (CHECK (id >= 0)), um nichtnegative Werte sicherzustellen. Da PostgreSQLs INT bis ~2,1 Milliarden reicht, genügt das für die meisten Workloads. Wenn Sie wirklich den 4,2-Milliarden-Bereich brauchen, wechseln Sie zu BIGINT.
F. Wie schlimm ist der Rundungsfehler von FLOAT in der Praxis?
A. FLOAT (4 Bytes) hat etwa 7 signifikante Stellen. Speichern Sie 123456,789 in FLOAT, bekommen Sie möglicherweise 123456,7890625 zurück. Für Sensordaten oder wissenschaftliche Messungen — wo das Instrument selbst eine begrenzte Genauigkeit hat — ist das irrelevant. Für Finanzberechnungen bedeutet es Rechnungen, die um einen Cent abweichen, und Monatssummen, die nicht aufgehen. Die Regel ist einfach: Verwenden Sie FLOAT niemals für Geldbeträge.
F. Ist DECIMAL wirklich langsamer als INT? Um wie viel?
A. Bei aggregationsintensiven Abfragen (SUM, AVG über Millionen Zeilen) kann DECIMAL 1,2–2× langsamer sein als INT. Für typische OLTP-Workloads — einzelne SELECTs und INSERTs — ist der Unterschied vernachlässigbar. Manche Teams speichern Preise als ganzzahlige Cent (z. B. 19,99 € → 1999), um INT-Geschwindigkeit zu nutzen, aber das scheitert, sobald Mehrwährungsunterstützung oder Sub-Cent-Berechnungen nötig werden. Mit DECIMAL zu starten ist die sicherere Langzeitwette.
Schreibe einen Kommentar